 Google · EmbeddingGemma 2 공식 발표 대표 이미지
영상 파일 이름이나 정확한 대사를 몰라도, 찾고 싶은 장면을 음성으로 설명해 검색하는 기능을 만들 수 있게 됐다. 구글은10월6일 공식 블로그에서 EmbeddingGemma2를 공개하고, 음성·텍스트로 영상 속 특정 순간을 찾는 Google AI Edge Gallery 데모를 소개했다. 한국시간7일01시04분 Google DeepMind의 공식 발표도 올라왔다. 새 모델은 글만 처리하던 이전 버전과 달리 사진·영상·음성까지 같은 검색 공간으로 연결한다.
말로 찾고, 영상에서 답을 받는 검색
핵심은 검색어와 찾을 자료의 형식이 꼭 같을 필요가 없다는 점이다. 구글이 제시한 Video Moments Finder는 텍스트나 음성으로 영상의 순간을 찾고, Instant Media Search는 글이나 이미지로 미디어를 검색한다. 이것은 질문에 맞춰 새 영상을 만들어 주는 생성 기능이 아니다. 이미 가진 자료를 내용의 의미로 찾는 검색 기능이다.
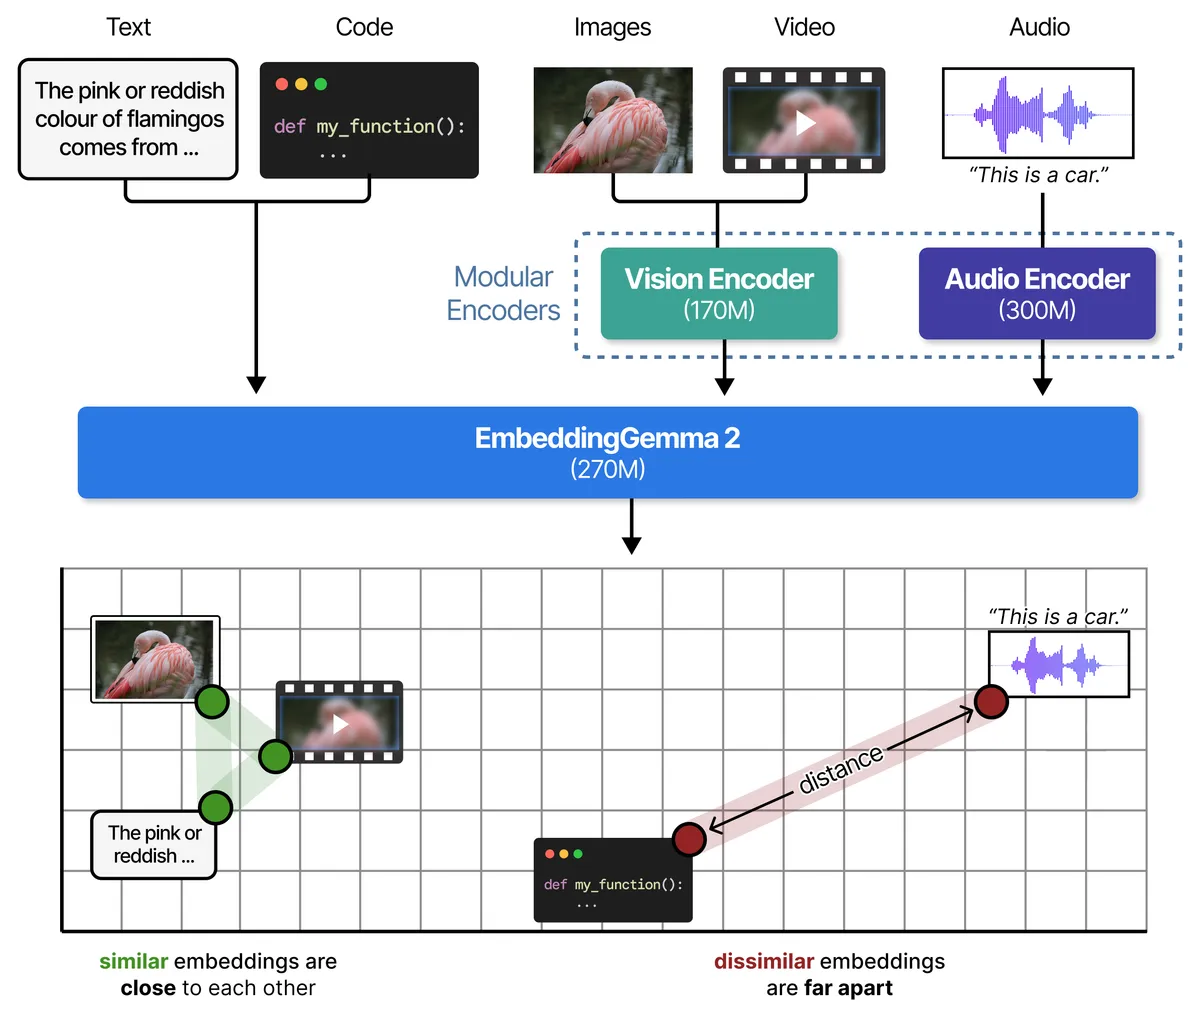
모델은 자료의 의미를 검색용 숫자 표현인 임베딩으로 바꾼다. 이전 EmbeddingGemma1은 텍스트 중심이었지만, 이번 버전은 텍스트와 코드에 더해 이미지·영상·음성을 함께 비교할 수 있다. 긴 녹음이나 여러 영상에서 원하는 내용을 찾아야 하는 이용자에게는, 파일명이나 한 가지 형식의 검색어에 의존하지 않는 앱이 나올 수 있다는 변화다.
공개 모델이다…일반 Gemini 앱의 새 버튼은 아니다
현재 공개된 것은 개발자가 검색 앱에 통합하는 모델과 사용 예시다. 일반 Gemini 앱에서 모든 이용자가 이 기능을 바로 쓸 수 있게 됐다는 발표는 아니다. Google은 Hugging Face와 Kaggle에 모델을 공개했으며, Apache2.0 라이선스를 적용했다고 밝혔다. Gemini Enterprise Agent Platform의 Model Garden 제공은 추후 계획으로 구분했다.
기기 안에서 처리하는 검색을 만들 수 있다는 것도 중요한 변화다. 개발자는 사진 검색에 필요한 부분만, 또는 음성 검색에 필요한 부분만 불러올 수 있다. 모든 입력을 지원하는 전체 모델을 항상 함께 실행해야 하는 구조가 아니다. 다만 기기 성능과 개발자가 선택한 구성에 따라 속도·메모리 사용량이 달라지므로 모든 휴대폰에서 같은 결과를 보장하는 것은 아니다.
한 번에 넣을 수 있는 자료에는 공통8,192토큰 한도가 있다. 텍스트·이미지·음성을 섞으면 같은 한도를 나눠 쓰며, 긴 영상 전체를 무제한으로 한 번에 검색하는 모델이라는 뜻은 아니다. 개발자가 자료를 나누고 검색용 목록을 구성해야 한다. 모델 카드도 언어마다 성능이 같지는 않으며, 저장 공간을 줄이는 설정에는 검색 품질의 손실이 있을 수 있다고 설명한다.
출처로 확인한 내용
5건
EmbeddingGemma2는 텍스트·코드·이미지·영상·음성을 같은 임베딩 공간으로 연결한다.
Google AI Edge Gallery의 예시에는 텍스트·음성으로 영상의 특정 순간을 찾는 Video Moments Finder가 있다.

Hugging Face와 Kaggle에 모델이 공개됐고 Apache2.0 라이선스이며 Model Garden 제공은 추후 계획이다.
텍스트·비전·오디오 구성 중 필요한 인코더만 불러올 수 있다.
입력은 공통8,192토큰 한도를 나눠 쓰고 축소한 출력 표현에는 검색 품질 손실이 있을 수 있다.