 Kandinsky Lab · 공식 영상 모델 페이지 프로모션 포스터, 공개 원문 보도 인용(허가 취득 아님)
AI 영상의 소리를 따로 붙이지 않고 함께 생성하는 공개 모델이 나왔다. Kandinsky Lab은 10월 6일 Kandinsky-6의 코드와 가중치를 공개했다. 텍스트 또는 이미지를 입력해 동기화된 소리가 있는 5초 영상을 만드는 모델이다. 오늘 새로 발표됐다는 뜻은 아니며, 이번 공개의 핵심은 모델을 직접 실행·연구할 수 있는 경로다.
작은 Lite와 큰 Pro, 영상 길이는 5초
공식 안내는 Lite와 Pro를 구분한다. Lite는 속도를 겨냥한 30억 매개변수 계열, Pro는 290억 매개변수 계열이다. 두 계열 모두 음성·영상 생성과 입 모양 동기화를 지원한다고 소개한다. 이것이 모든 문장에서 정확한 발음이나 자연스러운 입 모양을 보장한다는 뜻은 아니다.
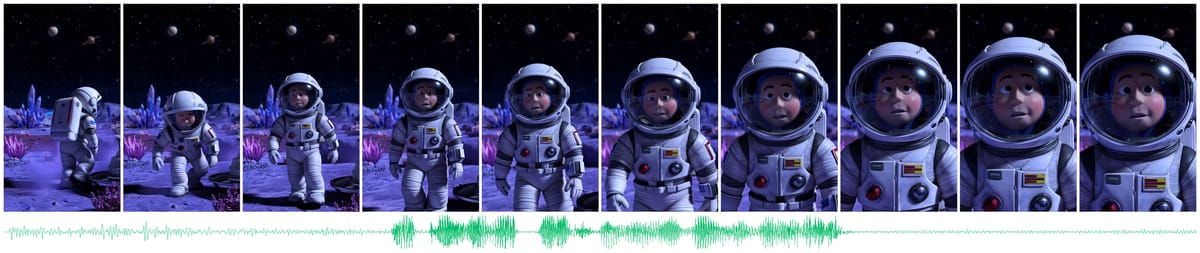
Lite의 기본 출력은 SD 해상도이고 별도 초해상도 모델로 Full HD까지 높이는 방식이다. 작은 모델이 처음부터 Full HD를 직접 생성하는 것처럼 읽으면 안 된다. 공식 문서의 모델 설명과 실제 자신의 장비에서 얻는 품질·속도도 구분할 필요가 있다.
‘공개 모델’이 곧 설치 없는 무료 사이트는 아니다
GitHub의 빠른 시작 안내에는 NVIDIA GPU, Python 3.13 또는 3.14, uv와 just가 필요 조건으로 적혀 있다. 실행 시 해당 모델의 체크포인트도 내려받는다. 모든 노트북에서 곧바로 실행되거나 별도 저장공간·연산 비용이 들지 않는다고 볼 수 없다.
코드 저장소에는 Lite·Pro의 학습·증류 모델과 여러 실행 경로가 나뉘어 있다. 자신의 장비와 맞는 설정을 확인하는 작업이 먼저다. PacPik은 이번 취재에서 대형 가중치를 내려받거나 직접 생성 성능을 측정하지 않았으며, 특정 GPU의 메모리 요구량·생성 시간을 검증한 수치로 제시하지 않는다.
앞서 소개한 코드 애니메이션이나 입력에 따라 이동하는 세계 모델과 달리, 이번 독자가 확인할 답은 소리가 붙은 짧은 영상을 생성하는 공개 모델의 실행 조건이다. 원문과 저장소를 함께 보면 ‘영상 생성 가능’과 ‘내 장비에서 바로 이용 가능’을 구분할 수 있다.
출처로 확인한 내용
3건
Kandinsky-6는 텍스트·이미지에서 동기화된 소리가 있는 5초 영상을 생성하는 공개 모델이다.
Lite는 SD 출력과 초해상도 경로를 구분한다.
공식 빠른 시작은 NVIDIA GPU·Python3.13/3.14·uv·just를 필요 조건으로 안내한다.