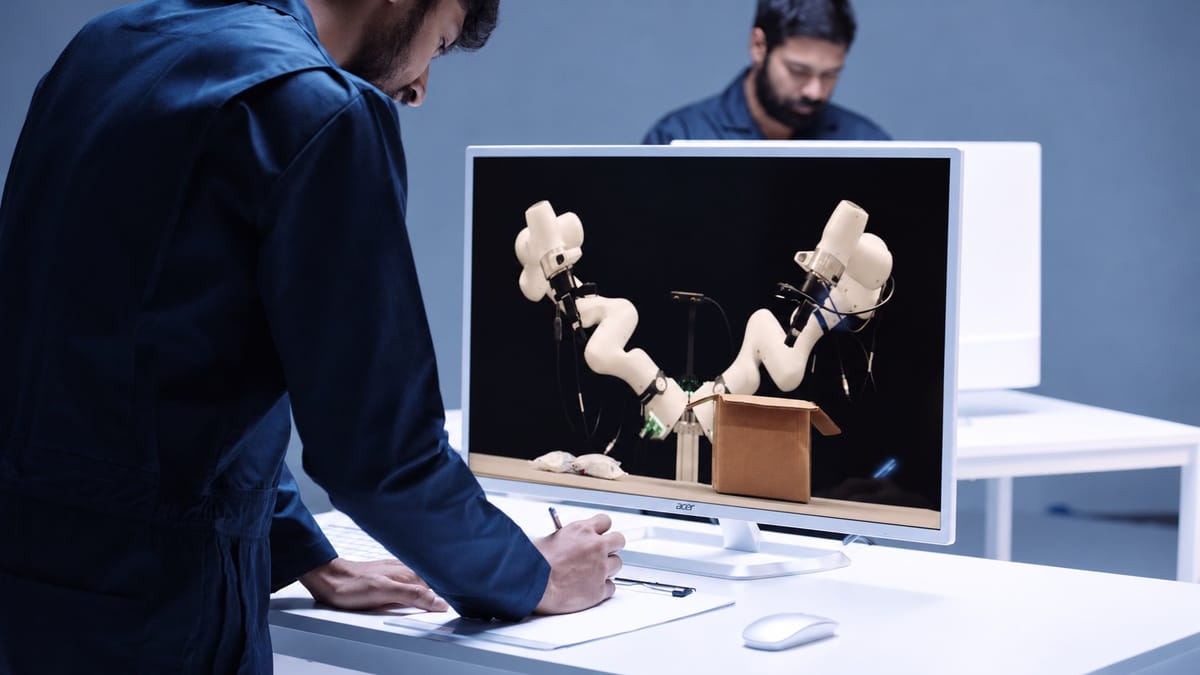
 Odyssey · 공식 발표 대표 이미지, 공개 원문 보도 인용(허가 취득 아님)
AI가 만든 영상을 끝까지 보는 대신, 그 안에서 움직이며 다음 장면을 바꾸는 연구 미리보기가 공개됐다. Odyssey가 10월 8일 발표한 Odyssey-3는 텍스트로 환경을 만들고, 이동이나 새 사건 입력에 따라 다음 상태를 실시간으로 예측하는 세계 모델이다.
1인칭·3인칭 이동, 카메라는 별도로
공식 안내는 1인칭과 3인칭 탐색에 더해 독립적인 카메라 움직임을 제공한다고 설명한다. 생성 도중 환경을 이동하거나 사건을 넣고 모델의 반응을 살펴보는 방식이다. 미리 정해진 영상의 재생 방향만 바꾸는 기능과는 다르다.
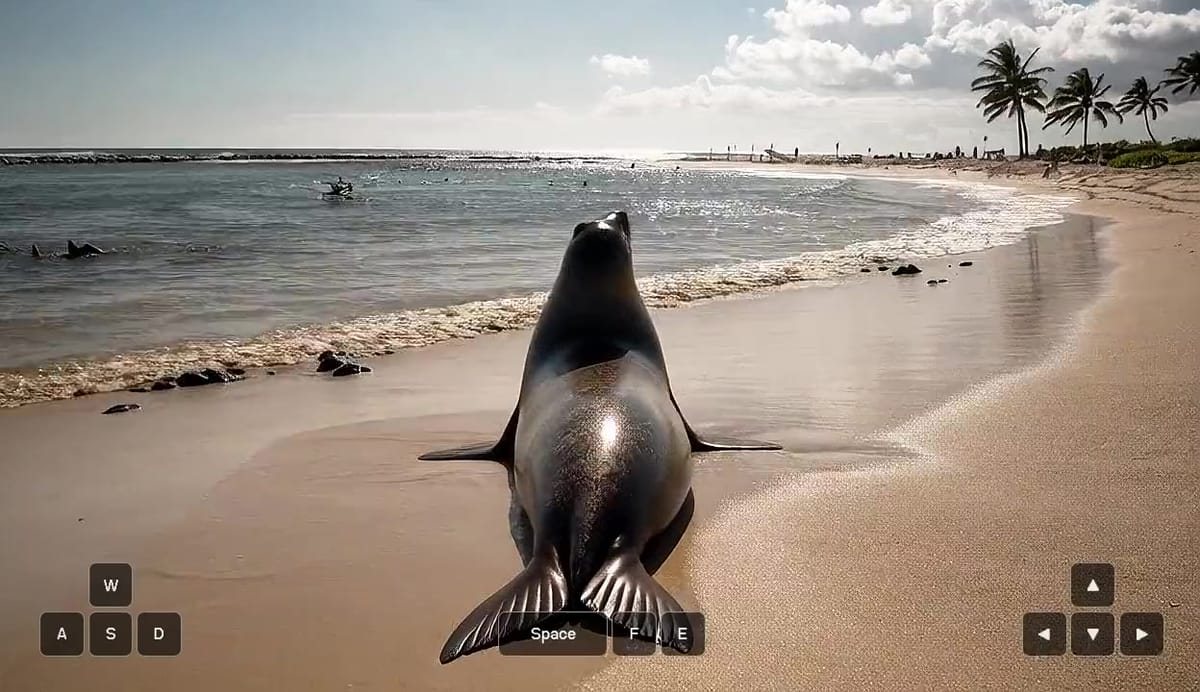
Odyssey는 이를 시각 관찰과 최신 입력을 바탕으로 다음 상태를 예측하는 학습된 동적 시스템으로 설명한다. 인터넷 영상, 조작 입력이 기록된 게임 영상, 시뮬레이션 자료 등이 훈련 구성에 포함됐다. 화면이 움직인다는 사실을 완벽한 물리 계산이나 상용 게임의 완성도로 바꿔 말할 수는 없다.
체험하는 Flash와 평가한 Pro를 구분해야
발표 페이지의 직접 체험 버튼은 Odyssey-3 Flash로 연결된다. 한편 회사가 Physics-IQ에서 최고 성능이라고 소개한 모델은 Odyssey-3 Pro다. 공개 체험과 성능 비교의 모델을 같은 것으로 읽으면 안 된다. 회사의 WorldMark 비교 역시 특정 환경·지표를 평가한 결과다.
한국시간 11일 0시 22분경 공식 체험 페이지에서는 대기열 화면을 확인했다. 따라서 누구나 기다림 없이 바로 이용한다고 안내할 근거는 없다. PacPik은 이번 취재에서 직접 환경을 생성해 이동 성능이나 물리 정확도를 시험하지 않았다.
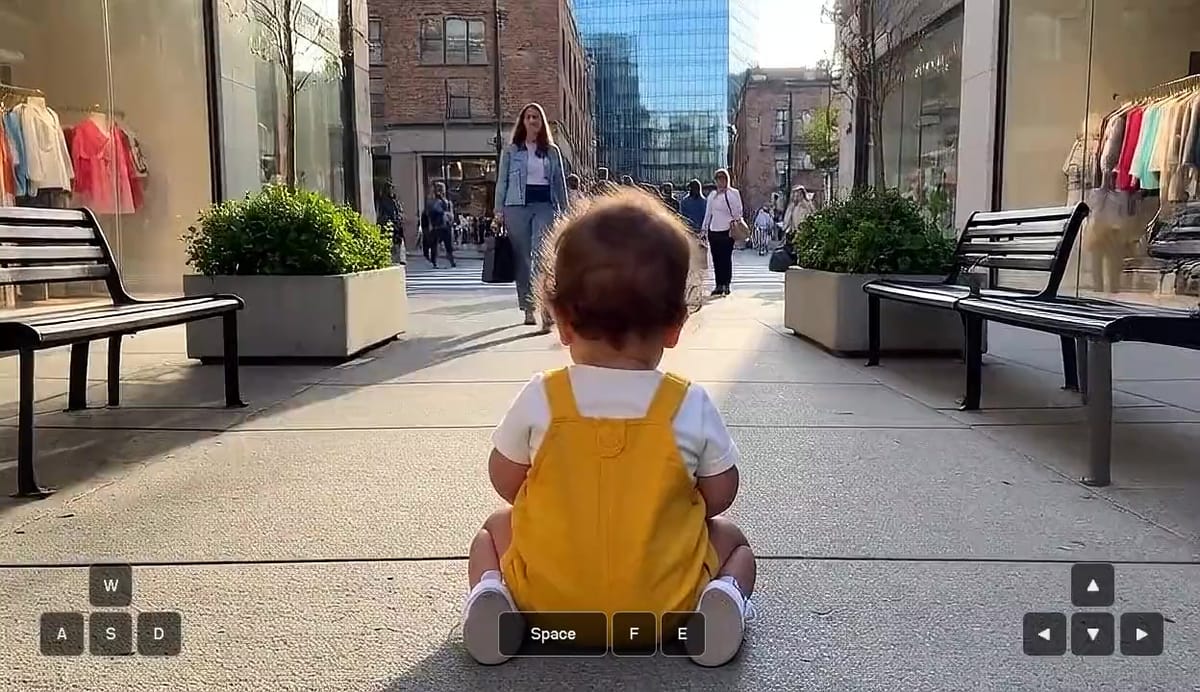
회사는 로봇·자율 시스템 개발자가 별도 조작 정책을 학습해 모델을 적용하는 연구도 함께 소개했다. 일반 독자가 지금 확인할 수 있는 구체적인 새 경험은 공식 연구 미리보기다. 가상 장면을 내가 조작하면 어떤 다음 장면이 생기는지 확인하는 접근이며, 실제 로봇의 안전한 작동이나 상용 배포를 보장하는 발표는 아니다.
출처로 확인한 내용
3건
Odyssey-3는 입력에 반응하는 실시간 생성 환경과 1·3인칭 탐색·독립 카메라 조작을 제공한다.
체험 버튼은 Flash이며 Physics-IQ 성능 발표의 모델은 Pro다.
취재 시 공식 미리보기에서 대기열 화면을 확인했다.