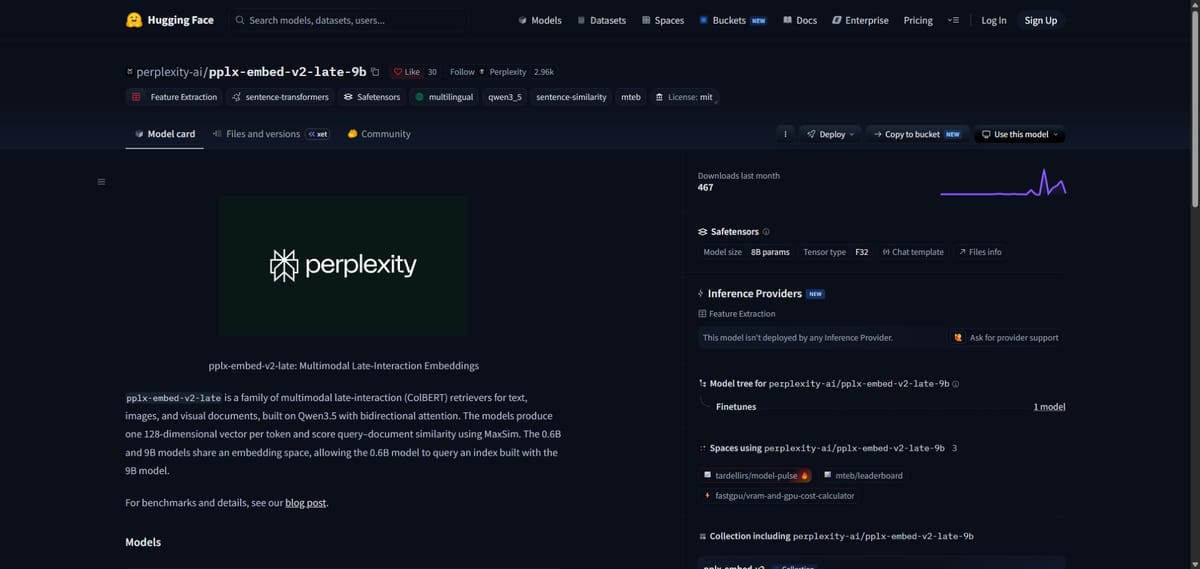
 ©Perplexity AI · 공식 모델 카드 실제 화면 · 보도 인용(허가 취득 아님)
PDF와 화면 캡처를 검색하는 서비스라면 자료를 처음 정리할 때와 이용자가 질문할 때 꼭 같은 크기의 AI를 돌려야 할까. 이번 주 퍼플렉시티가 공개한 pplx-embed-v2-late의 구체적 변화는 그 두 작업을 나눌 수 있다는 점이다. 공식 모델 카드에 따르면 9B 모델로 만든 색인을 작은 0.6B 모델이 검색할 수 있다. 두 모델이 같은 임베딩 공간을 공유하기 때문이다.
문서를 한 덩어리로 줄이는 검색과 다르다
이 모델군은 텍스트·이미지·시각적 문서를 검색 대상으로 삼는다. 문서 전체를 벡터 하나로 압축하는 대신 토큰마다 128차원 벡터를 만들고, 질문과 문서의 유사도를 MaxSim 방식으로 비교한다. 큰 모델로 자료를 미리 색인하고 작은 모델로 이용자의 질의를 처리하는 구성이 가능하다. 다만 모델 크기를 바꾸어도 어떤 자료에서나 검색 품질이 같다는 보장은 아니다.
실제 구현 조건도 있다. 공식 사용 예시는 텍스트만 있는 묶음과 이미지만 있는 묶음을 별도 인코딩 호출로 처리하도록 안내한다. 텍스트와 이미지를 섞은 입력 묶음은 지원하지 않는다. 따라서 ‘멀티모달’이라는 이름만 보고 모든 파일을 한 번의 호출에 섞어 넣을 수 있다고 해석하면 안 된다. 공개 모델의 가중치를 쓸 수 있다는 사실과 서버·저장공간·운영 비용이 사라진다는 주장도 서로 다르다.
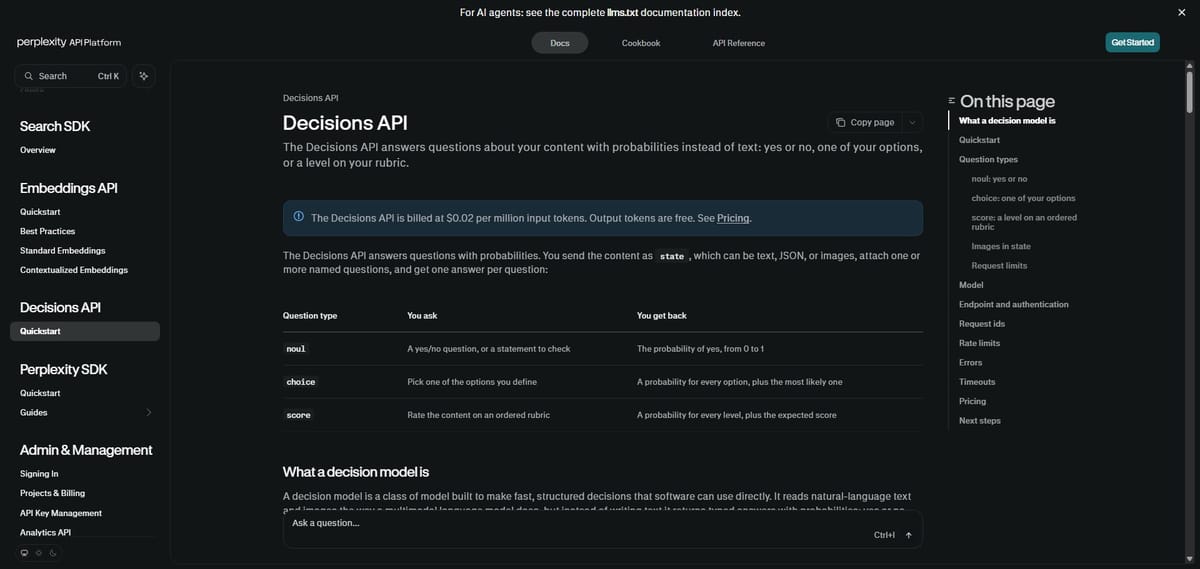
찾기와 판단은 같은 모델의 이름이 아니다
같은 주에 공개된 pplx-decider-v1.1-27b는 다른 역할이다. API는 주어진 텍스트·JSON·이미지에 대해 예·아니오 확률, 미리 정한 선택지별 확률, 순서가 있는 평가 단계의 기대 점수를 반환한다. 답변 문장을 쓰거나 판단 이유를 설명하는 챗봇이 아니다. 예를 들어 검색기로 관련 신청서 페이지를 찾고, 별도 결정 모델에 검토 기준을 묻는 연결은 설계할 수 있다. 이는 두 제품이 자동으로 결합돼 있다는 뜻이 아니라 사용자가 구성할 수 있는 작업 예시다.
Decider 문서의 confidence도 곧바로 실제 정답률은 아니다. 모델의 자체 확신 추정값이며 가장 높은 선택지 확률과도 구분된다. 사람이 검토할 경계값은 서비스가 정해야 한다. 이번 정리는 10월 5일부터 11일 취재 시점까지 공개된 원문을 대조한 것으로, 독자 자료에서의 정확도·속도·비용 절감을 실험한 결과가 아니다. 한국어 공개 글에서는 결정 모델의 벤치마크 소개가 관찰됐지만 임베딩 변경의 국내 관심 급증은 확인하지 않았다.
출처로 확인한 내용
5건
0.6B와9B는공유임베딩공간으로작은모델이큰모델색인을검색할수있다.
토큰당128차원벡터와MaxSim으로텍스트·이미지·시각문서를검색한다.
텍스트전용과이미지전용배치는별도인코딩하며혼합배치는지원하지않는다.
결정API는예·아니오/선택/순서형점수의확률을반환하며답변문장·이유를생성하지않는다.
confidence는모델자체확신추정이며최고선택지확률과별개다.