 PerturbAI · OpenAI 연구 소개의 공식 설명 영상 표지1700×956 원본 · AVIF를 WebP로 형식만 변환·보도 인용·별도 허가 취득 아님
실험 데이터가 많아지면 AI 한 명에게 더 큰 파일을 주면 될까. OpenAI·PerturbAI·스크립스 연구진이 택한 방법은 달랐다. 생쥐 뇌에서 유전자를 교란했을 때 나타나는 반응을1946개 에이전트가 나눠 맡고, 각자가 찾은 문헌과 해석을 다시 연결했다. OpenAI가21일 소개한 ‘분산 생물학적 추론’의 핵심은 모델 이름보다 일을 나누는 방식에 있다.
유전자 하나의 반응을 맡고, 근거까지 붙인다
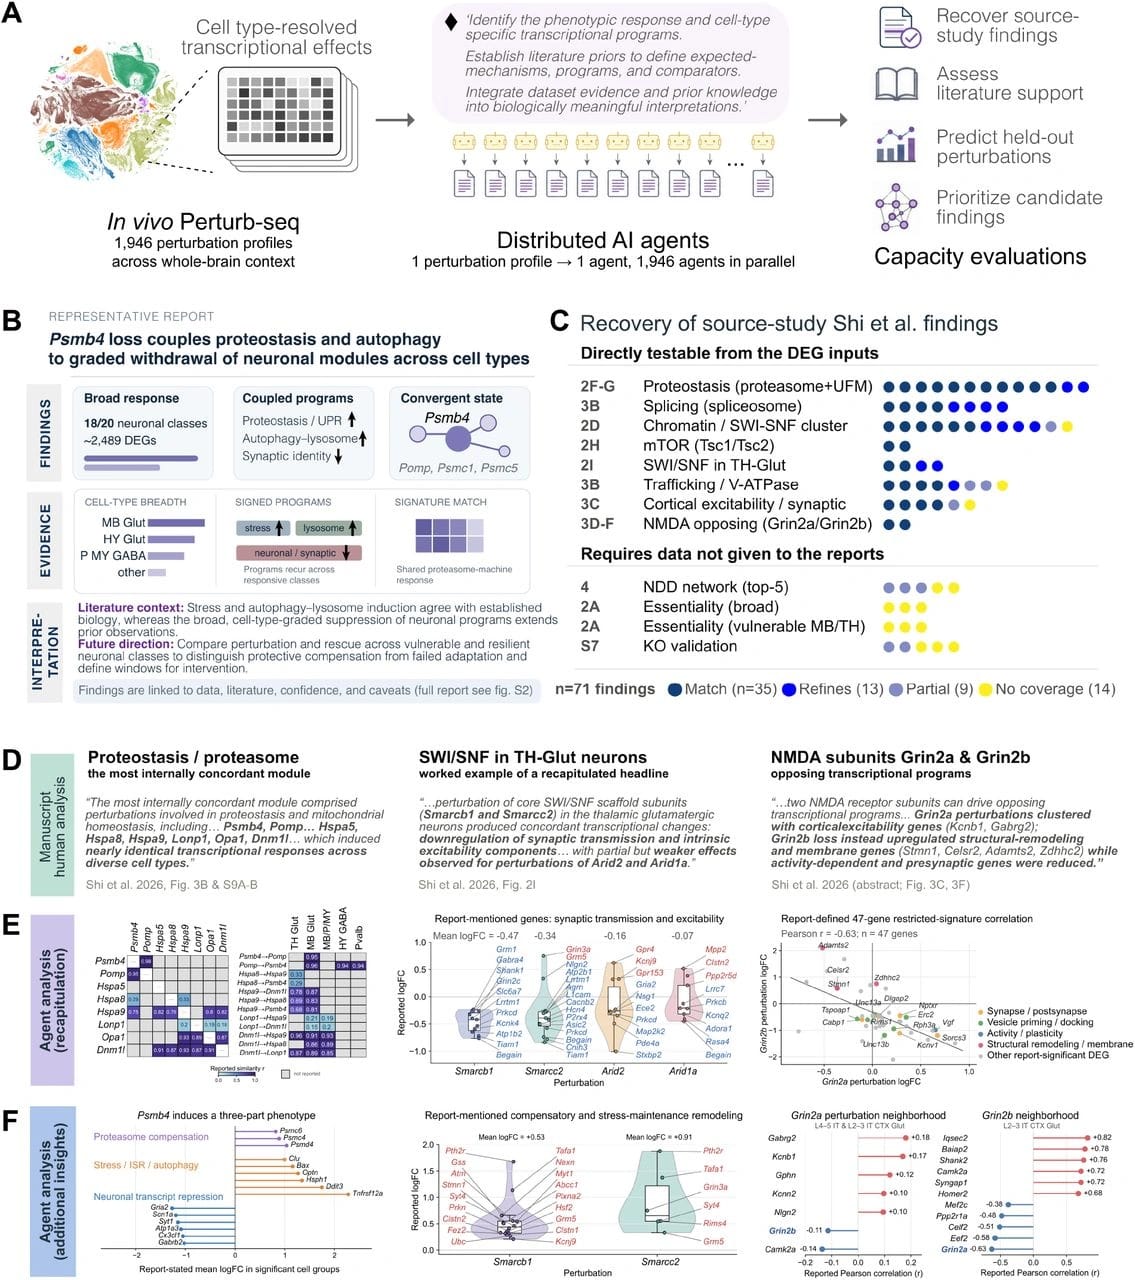
대상은 이미 수행한 대규모 생쥐 뇌 CRISPR 실험의 데이터다. 유전자 기능을 바꿨을 때 세포 종류별로 어떤 유전자 발현이 달라지는지를 살폈다. 에이전트마다 한 교란의 자료를 맡기고 분석 도구와 문헌 검색을 이용해 수치 근거·가능한 기전·주의점·다음 실험을 담은 보고서를 쓰도록 했다. 원 실험 논문과 결론은 제공하지 않았다. 기존 결과를 다시 찾는지와 추가 단서를 함께 평가하기 위해서다.
통째로 맡길 때보다 문헌의 폭을 넓혔다
연구진은 같은 모델·프롬프트·도구·데이터 접근 조건에서 단일 에이전트와 분산 방식을 비교했다. OpenAI의 소개에 따르면 가장 큰 작업량에서 단일 에이전트가 인용한 문헌은11개였지만 분산 방식은700개를 넘었다. 전문가의 익명 비교에서도 분산 보고서가75% 선택됐다. 모든 과학 질문에서 정확도가75%라는 뜻이 아니라, 비교한 보고서 쌍에 대한 선호 결과다. 사람이 걸렸을 몇 달에서1년이라는 시간도 실제 같은 사람이 모두 수행해 잰 기록이 아닌 연구진 추정이다.
보고서를 합치면 유전자·세포 반응·문헌 사이의 연결을 살펴볼 수 있다. 신경세포 안의 화물 이동에 관여하는 DCTN1의 교란에서 콜레스테롤 합성 관련 발현이 늘어난 관찰을, 콜레스테롤 운반에 관한 기존 연구와 연결한 것이 한 예다. ‘합성이 늘었다’에서 끝나지 않고 세포 안의 콜레스테롤 분포를 확인할 다음 실험을 제안했다. 이미 쌓인 실험에서 사람이 더 검증해 볼 질문을 뽑는 방식이다.
논문 공개와 치료 효과 입증은 다르다
원 논문은10월16일 bioRxiv에 사전 공개됐고 아직 동료심사를 거친 확정 결과가 아니다.21일의 OpenAI 소개와 최초 논문 공개일은 다르다. 생쥐 세포의 해석과 후속 가설을 사람의 질환 치료 효과로 옮겨 말할 수도 없다. 새 약의 효능을 입증한 임상시험이나 일반 사용자를 위한 치료 서비스 발표가 아니며, 연구팀도 기전을 확인할 추가 실험이 필요하다고 설명했다. 중요한 변화는 작은 질문을 병렬로 조사한 뒤 근거를 연결해 다음 실험을 고르는 과정까지 확장한 점이다.
출처로 확인한 내용
5건
원 논문은1946개 교란별 독립 에이전트에 자료를 배정하고 원 실험 논문·결론을 제공하지 않았다고 설명한다.

OpenAI는21일 기존 생쥐 뇌 세포 실험 데이터의 분산 에이전트 분석을 소개했다.
발표는 단일 에이전트 인용11개와 분산 방식700개 초과, 익명 전문가 비교의 분산 보고서 선호75%를 설명했다.
DCTN1·콜레스테롤 분포 연결은 추가 실험 가설이며 사람의 치료 효과를 검증한 결과가 아니다.
논문은10월16일 게시된 동료심사 전 사전 공개이며 CC BY4.0을 명시한다.